Teil 3: Neuronale Netze & Deep Learning +0
Sept. 23, 2026
KI, ML, Perzeptron
Moderne KI-Systeme verfügen heute über etablierte Ansätze für ihre Bau- und Lernprozesse, die eine vorhersehbare Effizienz und hohe Flexibilität gezeigt haben. Diese Verfahren wurden bei der Entwicklung des maschinellen Lernens eingesetzt, um komplexe Probleme zu lösen, die nicht mit festen Regeln beschrieben werden können, und um den unbegrenzten Datenumfang zu verarbeiten, der mit der Internetentwicklung entstanden ist.
Die Lösung wurde an der Schnittstelle von Disziplinen wie Biologie, Kognitionswissenschaft und Informatik gefunden. Von biologischen Neuronen im Gehirn und deren Fähigkeiten wie Wahrnehmung und Lernen wurde ein mathematisches Modell inspiriert, das als künstliches neuronales Netz bezeichnet wird.
Künstliche neuronale Netze
Künstliche neuronale Netze (KNN) sind heute der Standard für die Darstellung eines mathematischen Modells in KI-Systemen. Ein neuronales Netz besteht aus Neuronen. Ein Neuron ist eine mathematische Funktion. Es hat Eingaben und eine Ausgabe. Die Neuronen sind innerhalb des Netzes in Schichten organisiert. Es gibt eine Eingabeschicht zur Übertragung des Eingabesignals, und eine Ausgabeschicht, um das Arbeitsergebnis zu erhalten. Dazwischen befinden sich versteckte Schichten. Die Anzahl versteckter Schichten kann von 1 bis vielen reichen. Wenn es mehr als eine versteckte Schicht gibt, gilt das neuronale Netz als tief.
Neuron
Die Geschichte ihrer Erforschung begann in den frühen 1940er. Warren McCulloch (Neurophysiologe) und Walter Pitts (Mathematiker) entwickelten das erste mathematische Neuronenmodell. Sie veröffentlichten 1943 den Artikel A Logical Calculus of the Ideas Immanent in Nervous Activity, in dem sie biologische Prozesse mithilfe der Mathematik beschrieben. Die Forscher argumentieren, dass die physischen Verschaltungen des Gehirns funktional äquivalent zu den Strukturen der symbolischen Logik sind. Dies bildete die theoretische Grundlage für die Vorstellung des Gehirns als Rechenmaschine (Turing-Maschine), die Algorithmen ausführen kann.
Die wichtigsten Aspekte ihrer Arbeit sind:
- Das künstliche Neuron: Die Vorstellung, dass Nervenzellen nach einem binären Alles-oder-Nichts-Prinzip (1 oder 0) arbeiten, bei dem ein Neuron entweder einen Impuls aussendet oder nicht. Diese Eigenschaft erlaubt die Reaktion eines Neurons als logische Aussage (Proposition) behandeln.
- Schwellenwert (θ): Ein Neuron summiert Eingangssignale und erregt sich, wenn die Summe einen bestimmten Wert überschreitet. In KNN wird dieses Prinzip durch eine Aktivierungsfunktion umgesetzt.
- Neuronales Netz als logischer Operator: Die Verschaltung von Neuronen ermöglicht die Darstellung fundamentaler logischer Operatoren. Theoretisch kann für jeden logischen Ausdruck ein entsprechendes neuronales Netz konstruiert werden.
Ihr Modell funktioniert so, dass zur Aktivierung eines Neurons eine gewichtete Summe (net) der Eingaben berechnet wird. Die Gewichte sind Parametern der Synapsen (Verbindungen). Wenn es keine inhibitorische Synapse gibt und die Summe einen Schwellenwert (θ) überschreitet, dann wird das Neuron aktiviert.
Es ist wichtig zu sagen, dass es kein Begriff der Gewichte (wᵢ) im ursprünglichen McCulloch-Pitts-Artikel gab. Also es ist möglich zu sagen, dass alle Gewichte den 1 äquivalent sind. Die Eingabesynapsen konnten nur aktiv oder nicht sein (1, 0).
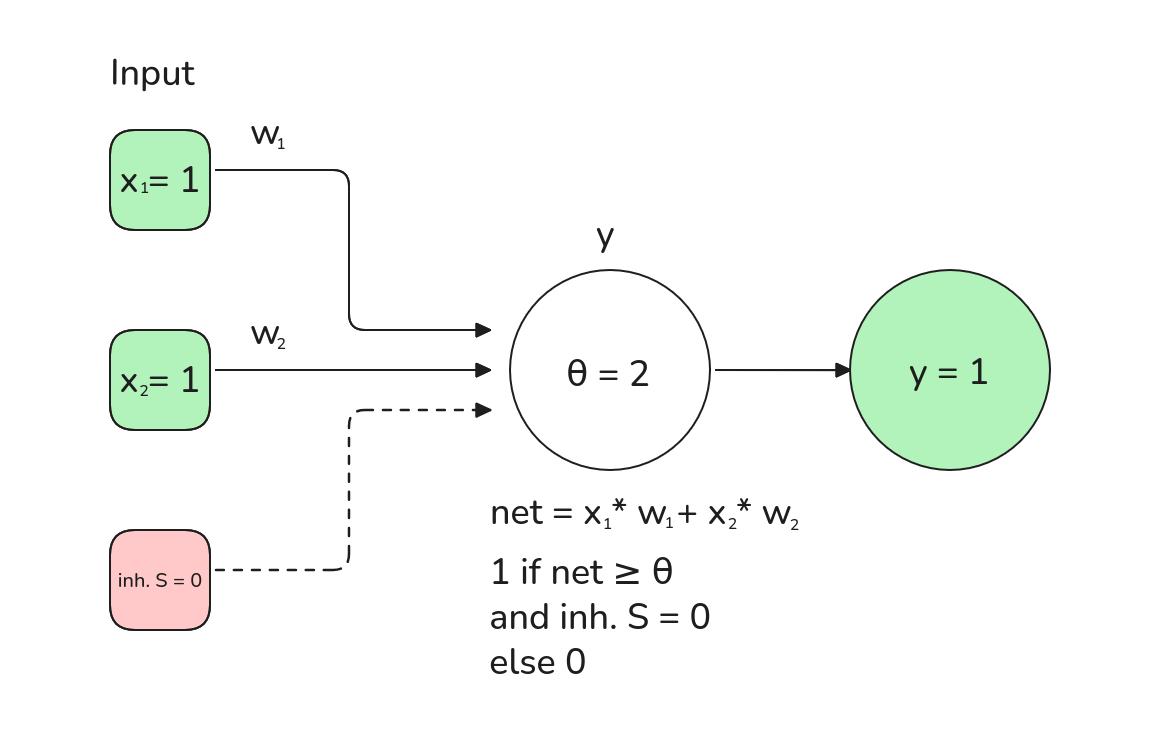 Darstellung eines McCulloch-Pitts-Neurons mit gewichteten Summe und Aktivierungsfunktion. Die inhibitorische Synapse ist 0 (inaktiv).
Die folgende Python-Implementierung zeigt die Funktionsweise eines McCulloch-Pitts-Neurons mit einer Heaviside-Aktivierungsfunktion (Treppenfunktion) und einer inhibitorischen Synapse:
def step_function(x, t):
    """Aktivierungsfunktion: Heaviside-Funktion (Treppenfunktion)"""
    return 1 if x >= t else 0


class McCullochPittsNeuron:
    def __init__(self, weights, threshold):
        self.weights = weights
        self.threshold = threshold

    def feedforward(self, inputs, inhibitory):
        # Überprüft die inhibitorische Synapse und berechnet
        # die gewichtete Summe
        if inhibitory:
            return 0
        s = sum(x * w for x, w in zip(inputs, self.weights))
        return step_function(s, self.threshold)


weights = [1, 1, 1]  # w1 = 1, w2 = 1, w3 = 1
t = 2  # Schwellenwert t = 2
n = McCullochPittsNeuron(weights, t)

inputs = [1, 0, 1]  # x1 = 1, x2 = 0, x3 = 1: alle drei Eingänge sind ansteurbar
inh_s = False
print(n.feedforward(inputs, inh_s))  # Ausgabe: 1
Das oben dargestellte Funktionsprinzip zeigt den Betriebsmodus, der heute als Inference bezeichnet wird. Das bedeutet, wie ein manuelles erstelltes oder bereits trainiertes Neuron funktioniert.
Bei der Verknüpfung von Neuronen in einem Netz dient die Ausgabe eines Neuron als Eingabe für ein anderes Neurons. Das Netz aus McCulloch-Pitts-Neuronen kann alle logischen Funktionen umsetzen, daher kann es beliebige logische Aufgaben lösen, die durch logische Operationen dargestellt werden können. Das ist die wichtigste Schlussfolgerung ihrer Arbeit.
Die Ideen von McCulloch und Pitts bilden das Fundament der heutigen künstlichen Intelligenz und der weiteren Entwicklung von künstlichen neuronalen Netzen.
Allerdings gaben McCulloch und Pitts keine Lernmethode für ihr Modell. Die Gewichte bzw. die Stärke der Synapsenverbindungen sollten manuell erstellt werden.
Perzeptron
Der kanadische Psychobiologe Donald Hebb formulierte 1949 in seinem Buch The Organisation of Behavior eine Theorie und Regel für die Änderung von Synapsenverbindungen. Vor Hebb mussten KNN für eine konkrete Aufgabe manuell entworfen werden. Die hebbische Lernregel erklärt, wie sich die Gewichte von selbst ohne einen Lehrer (Unsupervised Learning) durch Erfahrung ändern können.
Hebbs Regel klingt im Original in etwa wie folgt:
"Wenn ein Axon der Zelle A Zelle B erregt und wiederholt und dauerhaft zur Erzeugung von Aktionspotentialen in Zelle B beiträgt, so resultiert dies in Wachstumsprozessen in einer oder beiden Zellen, die bewirken, dass die Effizienz von Zelle A in Bezug auf die Erzeugung eines Aktionspotentials in B größer wird."
Das bedeutet: wenn zwei Neuronen gleichzeitig aktiviert werden, wird die Verbindung zwischen ihnen verstärkt. Mathematisch wird dies ausgedrückt wie: mit
- : Änderung des Gewichts der Verbindung von Neuron zu Neuron
- : Lernrate. Ein kleiner positiver Koeffizient, der bestimmt, wie sich das Gewicht bei jedem Trainingsschritt ändert. Wenn zu groß ist (), springen die Gewichte über den gewünschte Wert hinaus und weichen voneinander ab. Wenn er zu klein ist, verläuft der Lernprozess richtig, aber extrem langsam. Typische Werte sind in der Praxis von 0,1 bis 0,0001
- : Aktivierung des Neurons
- : Aktivierung des Neurons
Das ist die erste Vorstellung, dass eine Synapse einen veränderbaren Wert hat. Hebb gab ein Konzept, wie ein Gehirn ohne Lehrer, richtige Antwort und Fehlersignal lernt. Das ist unüberwachtes Lernen in Reinform. Das überwachte Lernen kam später.
Frank Rosenblatt entwickelte 1958 die Ideen des McCulloch-Pitts-Neurons und der Hebbschen Lernregel weiter, beschrieb und implementierte eine der ersten Softwareversionen eines neuronalen Netzes für IBM 704. Er bezeichnete es als Perzeptron. Später baute er mit dem Mark I Perceptron eine Hardware-Version des Systems, das mithilfe eines 20x20-Rasters aus Fotozellen Bilder erkennen konnte, darunter sogar handgeschriebene lateinische Buchstaben.
Rosenblatts System bestand aus drei Schichten von Neuronen: S-Einheiten (sensorische), A-Einheiten (assoziative) und R-Einheiten (Reaktionseinheiten). Der Lernprozess bestand darin, dass die Gewichte wᵢ der A->R-Verbindungen angepasst wurden. Die Gewichte der S->A-Verbindungen wurden hingegen manuell festgelegt und während des Trainings nicht verändert. Ansonsten blieb das Neuronenmodell unverändert. Es berechnete weiterhin eine gewichtete Summe der Eingänge und prüfte anhand einer Treppenfunktion, ob diese den Schwellenwert erreichte.
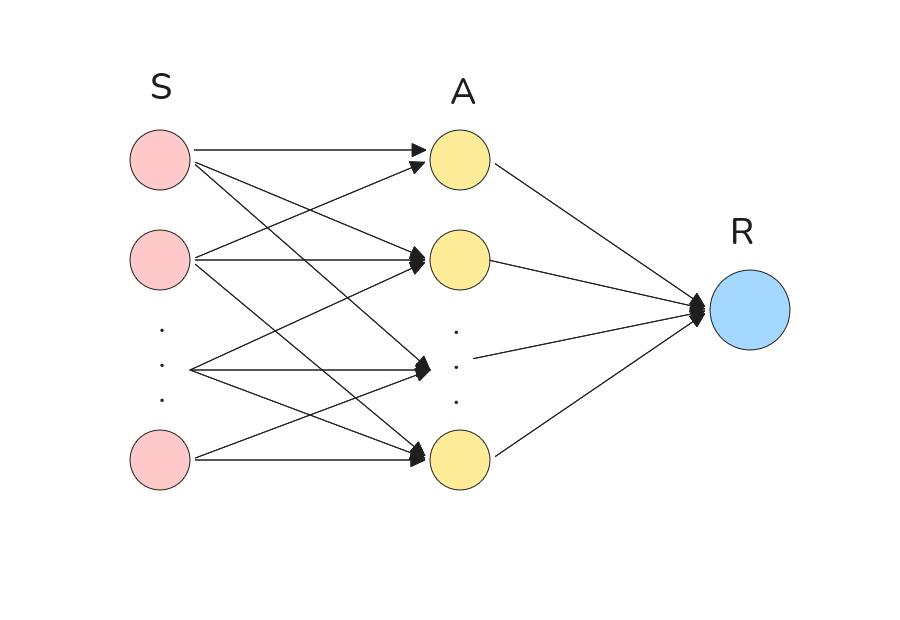 Das Schema eines einfachen Perzeptrons. Die Gewichte der S->A-Verbindungen können die Werte -1, 1 oder 0 annehmen. Die Gewichte der A->R-Verbindungen können beliebige Werte besitzen.
Die wichtigste Änderung betrifft also die Gewichte. Diese konnten nun reelle Werte annehmen, z. B. , . Darüber hinaus ergänzte Rosenblatt die Hebbsche Regel um eine neue Komponente: nämlich die Differenz zwischen dem gewünschten und dem tatsächlichen Ergebnis (): Bei der Klassifikation von Lernalgorithmen in seinem Buch Principles of Neurodynamics bezeichnete Rosenblatt solche Verfahren als Verstärkungssysteme. Seine Verstärkungsregel ist eine Kombination aus der Hebb-Regel und einem Fehlersignal. Dadurch wird das Gewicht nicht nur bei einer gleichzeitigen Aktivierung von Neuronen verändert, sondern auch bei einem falschen Ergebnis eines Neurons. Das ist eine klassische Methode des überwachten Lernens - die Fehlerkorrekturmethode.
Außerdem wies Rosenblatt das Konvergenztheorem des Perzeptrons nach. Darin zeigte er, dass ein einfaches Perzeptron, das mit der Fehlerkorrekturmethode trainiert wurde, die Lösung einer Aufgabe innerhalb einer begrenzten Anzahl von Lernschritten finden kann. Der Anfangszustand der Gewichte ist dabei ebenso wenig wichtig wie die Reihenfolge, in der die Elemente der Trainingsstichprobe verarbeitet werden – vorausgesetzt, die Daten sind linear trennbar.
Dies ist eine entscheidende Bedingung, da das Perzeptron ein linearer Klassifikator ist. Es erhält eine Menge numerischer Merkmale eines Objekts als Eingabe und entscheidet, zu welcher von zwei Klassen das Objekt gehört, indem es 0 oder 1 ausgibt. Dazu legt es eine trennende Gerade in einem Merkmalsraum (eine Hyperebene) fest und "schaut", auf welcher Seite das Objekt liegt. Hier liegt die wichtigste Einschränkung: Das Perzeptron kann eine Aufgabe nur dann lösen, wenn die Klassen linear trennbar sind, also eine solche Gerade existiert. Sind die Objekte zweier Klassen so vermischt, dass sie sich nicht mit einer Geraden trennen lassen, konvergiert das Training nicht.
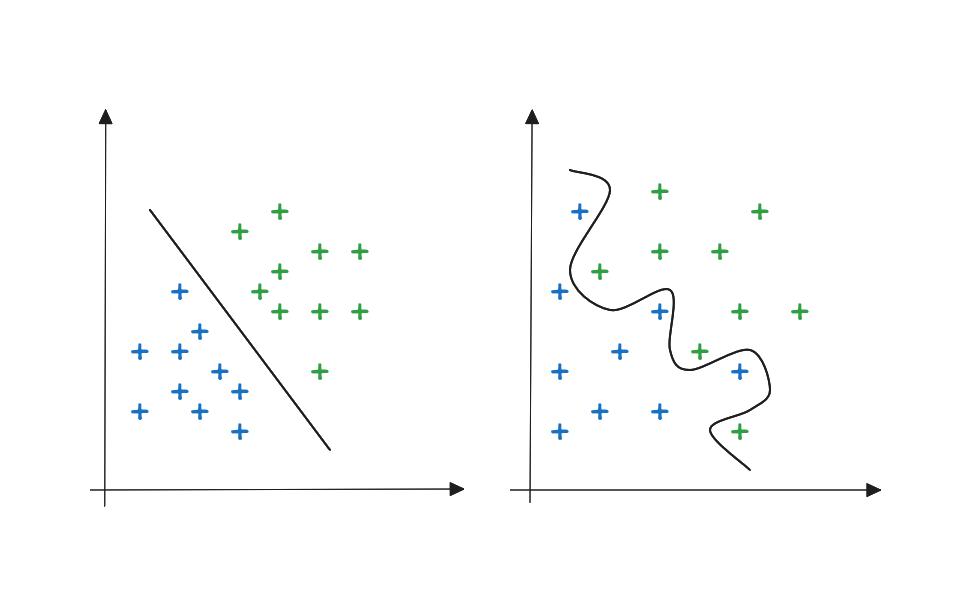 Zwei Klassen linear trennbarer Objekte und zwei Klassen linear untrennbarer Objekte.
Neben neuronalen Netzen interessierte sich Frank Rosenblatt sehr für die Astronomie und nahm an Projekten zur Suche nach extraterrestrischer Intelligenz (SETI) teil. Deshalb betrachten wir eine fiktive Aufgabe zur Klassifikation astronomischer Objekte, um die Funktionsweise eines einfachen Perzeptrons zu veranschaulichen.
Nehmen wir an, dass die Daten von Himmelskörpern, die uns von einem Teleskop geliefert werden, klassifiziert werden müssen: Handelt es sich um einen Stern oder eine Galaxie? Betrachten wir dazu zwei Merkmale:
- Helligkeit: von 0 bis 10
- Ausdehnung: von 0 bis 10
Sterne sind normalerweise hell und kompakt, während Galaxien ausgedehnter sind.
Für ein Lehrbeispiel müssen keine realen astronomischen Parameter verwendet werden. Wichtig ist lediglich, dass die Merkmale linear trennbar sind. Dann kann das einschichtige Rosenblatt-Perzeptron sie erlernen. Wenn sich die Merkmale von Sternen und Galaxien stark überschneiden, wäre ein komplexeres Modell erforderlich.
| Objekt | Helligkeit | Ausdehnung | Klasse |
|---|---|---|---|
| Vega | 9 | 1 | Stern |
| Sirius | 8 | 2 | Stern |
| Arcturus | 10 | 1 | Stern |
| Polaris | 7 | 1 | Stern |
| Andromeda | 4 | 8 | Galaxie |
| Milky Way | 3 | 9 | Galaxie |
| Triangulum | 5 | 7 | Galaxie |
| Whirlpool | 2 | 10 | Galaxie |
| Eine kleine Trainingstichprobe könnte wie folgt aussehen: |
training_data = [
    ("Vega", [9, 1], 0),  # Stern
    ("Sirius", [8, 2], 0),  # Stern
    ("Arcturus", [10, 1], 0),  # Stern
    ("Polaris", [7, 1], 0),  # Stern
    ("Andromeda", [4, 8], 1),  # Galaxie
    ("Milky Way", [3, 9], 1),  # Galaxie
    ("Triangulum", [5, 7], 1),  # Galaxie
    ("Whirlpool", [2, 10], 1),  # Galaxie
]
Dabei gilt die folgende Konvention:
0 = Stern
1 = Galaxie
Nun zum Perzeptron. Wir erinnern uns daran, dass Rosenblatt eine dreischichtige Architektur beschrieb. In der Praxis werden S->A-Verbindungen in den heutigen Trainingsimplementierungen jedoch häufig weggelassen, sodass stattdessen ein einschichtiges Modell trainiert wird. Der folgende Code setzt genau dies um:
class Perceptron:
    def __init__(self, n_inputs, learning_rate=0.1):
        self.weights = [0.0] * n_inputs
        self.bias = 0.0
        self.learning_rate = learning_rate

    def step_function(self, net_input):
        # Aktivierungsfunktion: Heaviside-Funktion (Treppenfunktion)
        return 1 if net_input >= 0 else 0

    def predict(self, inputs):
        # Berechnet die gewichtete Summe, fügt den Bias hinzu
        # und wendet die Aktivierungsfunktion an
        s = sum(x * w for x, w in zip(inputs, self.weights)) + self.bias
        return self.step_function(s)

    def train(self, training_data, epochs):
        # Aktualisiert die Gewichte und den Bias
        # nach der Perzeptron-Lernregel: Δw = η · x · (target − y)
        for _ in range(epochs):
            for inputs, target in training_data:
                prediction = self.predict(inputs)
                error = target - prediction

                for i in range(len(self.weights)):
                    self.weights[i] += self.learning_rate * inputs[i] * error

                self.bias += self.learning_rate * error


training_data = [
    ("Vega", [9, 1], 0),  # Stern
    ("Sirius", [8, 2], 0),  # Stern
    ("Arcturus", [10, 1], 0),  # Stern
    ("Polaris", [7, 1], 0),  # Stern
    ("Andromeda", [4, 8], 1),  # Galaxie
    ("Milky Way", [3, 9], 1),  # Galaxie
    ("Triangulum", [5, 7], 1),  # Galaxie
    ("Whirlpool", [2, 10], 1),  # Galaxie
]

prepared_training_data = [
    (features, target)
    for _, features, target in training_data
]

p = Perceptron(n_inputs=2) # Eingabe: Helligkeit und Ausdehnung
p.train(prepared_training_data, epochs=10)

# Testen wir das trainierte Modell mit den neuen unmarkierten Daten
data = [
    ("Betelgeuse", [8, 1]),
    ("Pinwheel", [3, 8]),
    ("Rigel", [9, 2]),
    ("Alpha Centauri", [7, 1]),
    ("Sombrero", [4, 7]),
    ("Cartwheel", [2, 9]),
]

for name, features in data:
    prediction = p.predict(features)

    print(f"{name} ist {'Galaxie' if prediction else 'Stern'}")
Die Ausgabe ist:
Betelgeuse ist Stern
Pinwheel ist Galaxie
Rigel ist Stern
Alpha Centauri ist Stern
Sombrero ist Galaxie
Cartwheel ist Galaxie
Im Unterschied zum McCulloch-Pitts-Neuron wurde der Schwellenwert θ als lernfähiger Bias b in die Summe integriert. Deshalb wird die Summe in step_function mit null statt mit θ verglichen. Schwellenwert und Bias sind also mathematisch äquivalent. Der Unterschied besteht lediglich darin, auf welcher Seite des Vergleichs die Zahl steht: rechts als Schwellenwert oder links mit negativem Vorzeichen in der Summe. Dieses Verfahren wurde später zum Standard in vielen Implementierungen, die mit Backpropagation trainiert werden.
Rosenblatt betrachtete auch Systeme mit mehreren Lernschichten. Er hatte allerdings keine Verfahren, um sie zu trainieren. Die Fehlerkorrekturmethode funktioniert nur beim konkreten Fehler eines Neurons. Der Fehler ist offenbar für eine Ausgabeschicht: Es gibt target und y und ihr Unterschied. Aber für eine versteckte Schicht ist target unbekannt, zudem sind ihre richtigen Ausgaben auch unbekannt. Rosenblatt versuchte dieses Problem mithilfe der Raffinessen und Heuristiken lösen, hat er jedoch keinen funktionierenden Algorithmus der Verbreitung des Fehlers für versteckte Schichten gefunden. Demnach existierte das mehrlagige Perzeptron nur als Idee und nicht als System, das man trainieren kann.
Trotz des durchschlagenden Erfolgs und der Euphorie in der Presse nach der Mark I-Demonstration zeigten sich Marvin Minsky und Seymour Papert pessimistisch in Bezug auf die Perspektiven des Perzeptrons. Sie bewiesen 1969 in ihrem Buch Perceptrons, dass das einlagige Modell bei nichtlinearen Aufgaben eingeschränkt ist. Der Beweis beruhte auf der Paritätsfunktion und dem Prädikat der Zusammenhängigkeit; das weithin bekannte XOR-Beispiel ist ein Sonderfall der Parität für zwei Eingänge, der sich in der späteren Literatur als einfachstes Beispiel für dasselbe Problem etabliert hat.
Was das bedeutet, veranschaulichen wir an unserem Beispiel des Perzeptrons, das Daten vom Teleskop klassifiziert.
Um zu zeigen, wie das Perzeptron nicht konvergent sein kann, setzen wir im Beispiel mit Sternen und Galaxien in der Methode train statt _ die Variable epoch und den Zähler errors ein. Nach jedem Durchgang (Epoche) durch die Trainingsstichprobe zählen wir die Fehler und geben ihre Anzahl auf dem Bildschirm aus:
class Perceptron:
    ...

    def train(self, training_data, epochs):
        # Aktualisiert die Gewichte nach der Perzeptron-Lernregel:
        # Δw = η · x · (target − y). Wir zählen die Fehler pro Epoche,
        # statt einfach blind zu trainieren
        for epoch in range(epochs):
            errors = 0
            for inputs, target in training_data:
                prediction = self.predict(inputs)
                error = target - prediction

                if error != 0:
                    errors += 1

                for i in range(len(self.weights)):
                    self.weights[i] += self.learning_rate * inputs[i] * error

                self.bias += self.learning_rate * error

            print(
                f"Epoche {epoch + 1}: {errors} Fehler von {len(training_data)}"
            )


training_data = [
    ("Vega", [9, 1], 0),  # Stern
    ("Sirius", [8, 2], 0),  # Stern
    ("Arcturus", [10, 1], 0),  # Stern
    ("Polaris", [7, 1], 0),  # Stern
    ("Andromeda", [4, 8], 1),  # Galaxie
    ("Milky Way", [3, 9], 1),  # Galaxie
    ("Triangulum", [5, 7], 1),  # Galaxie
    ("Whirlpool", [2, 10], 1),  # Galaxie
]

...

p = Perceptron(n_inputs=2)
p.train(prepared_training_data, epochs=10)
Das Training unseres Modells konvergiert nach ein paar Epochen:
Epoche 1: 2 Fehler von 8
Epoche 2: 0 Fehler von 8
Epoche 3: 0 Fehler von 8
Epoche 4: 0 Fehler von 8
Epoche 5: 0 Fehler von 8
Epoche 6: 0 Fehler von 8
Epoche 7: 0 Fehler von 8
Epoche 8: 0 Fehler von 8
Epoche 9: 0 Fehler von 8
Epoche 10: 0 Fehler von 8
Zwar erscheint der Begriff des Durchgangs durch die Trainingsstichprobe bereits bei Rosenblatt, doch bezeichnete man das später als Epoche - beim Batch-Training, da es wichtig war, wie oft das Netz den gesamten Datensatz "gesehen" hatte.
Allerdings sind die Sterne und die Galaxien bisher ideal getrennt, deswegen konvergiert alles. Aber jetzt kamen die Daten von einem Teleskop über ein System, in dem innere Objekte sich im Zentrum ballen und äußere einen Ring bilden. Wie auf einer Karte des Sonnensystems aus der Vogelperspektive - die Planeten sind im Inneren, die Objekte des Kuipergürtels außen am Rand.
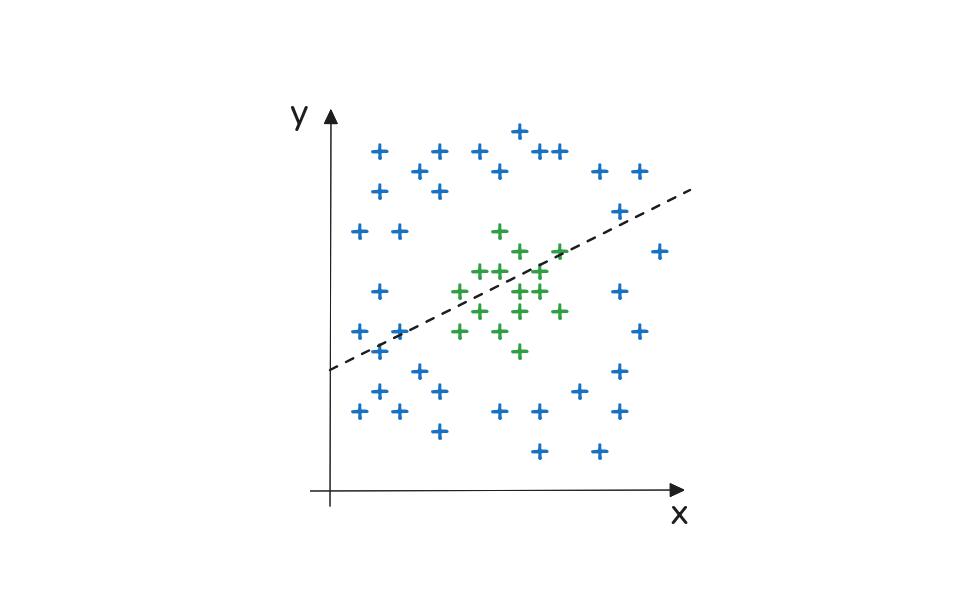
In diesem Fall sind die Merkmale nicht Helligkeit und Ausdehnung, sondern die Position (X, Y) auf einer Bildebene. Die Klasse des Objekts hängt vom Abstand zum Zentrum ab. Das Perzeptron kann nicht solche Gerade festlegen, die das Zentrum vom Rand separieren kann.
import random
import math


class Perceptron:
    ...


random.seed(42) # für reproduzierbare Ergebnisse


def generate_objects(n, r0, r1, label):
    # Erzeugt Objekte in einem ringförmigen Bereich um das Zentrum.
    # r0..r1 ist der Abstand vom Zentrum, der Winkel ist zufällig.
    objects = []
    for _ in range(n):
        r = random.uniform(r0, r1)
        theta = random.uniform(0, 2 * math.pi)
        x = r * math.cos(theta)
        y = r * math.sin(theta)
        objects.append(([x, y], label))
    return objects

# Inneres, kompaktes System (z.B. innere Planeten) -> Klasse 0
# Äußerer Gürtel (z.B. Kuipergürtel-Objekte) -> Klasse 1
inner = generate_objects(50, 0.0, 2.5, 0)
outer = generate_objects(50, 4.0, 6.0, 1)
training_data = inner + outer
random.shuffle(training_data)

p = Perceptron(n_inputs=2) # Eingabe: Position X und Position Y
p.train(training_data, epochs=10)
Die Ausgabe sieht so aus:
Epoche 1: 55 Fehler von 100
Epoche 2: 55 Fehler von 100
Epoche 3: 60 Fehler von 100
Epoche 4: 59 Fehler von 100
Epoche 5: 55 Fehler von 100
Epoche 6: 54 Fehler von 100
Epoche 7: 53 Fehler von 100
Epoche 8: 54 Fehler von 100
Epoche 9: 59 Fehler von 100
Epoche 10: 56 Fehler von 100
Jede beliebige Gerade schneidet beide Klassen ungefähr in der Mitte, deswegen erhalten wir ~55 von 100 in der Ausgabe, weil keine richtige Lösung für diese Aufgabe existiert.
Die strengen Ergebnisse, die Minsky und Papert beschrieben haben, haben das Vertrauen in die Richtung der neuronalen Netze lange untergraben. Das Interesse ließ nach und die Finanzierung wurde zur symbolischen KI gelenkt, die damals vielversprechender aussah. Dies fiel mit einer allgemeineren "Abkühlung" in diesem Bereich zusammen. Anfang der 1970er Jahre wurden die Budgets für KI-Projekte insgesamt gekürzt (unter anderem nach dem Lighthill-Bericht in Großbritannien), insbesondere für solche, die keine eindeutigen praktischen Ergebnisse lieferten. Es kam zum ersten "KI-Winter".
Backpropagation
Das Problem, auf das Rosenblatt gestoßen war, wurde erst 1986 gelöst. Bis dahin blieb ein mehrlagiges Netz nur eine schöne Idee, aber ohne eine Möglichkeit zu lernen.
Die Antwort haben David Rumelhart, Geoffrey Hinton und Ronald Williams gefunden. Sie veröffentlichten den Artikel Learning representations by back-propagating errors, in dem sie den Algorithmus Backpropagation bzw. die Fehlerrückführung beschrieben haben. Obwohl Seppo Linnainmaa den Algorithmus schon 1970 entwickelt hatte und Paul Werbos 1974 ihn auf neuronale Netze angewandt hatte, zeigte gerade dieser Artikel überzeugend, dass Backprop mehrlagige Netze wirklich trainieren kann. Das Interesse an neuronalen Netzen stieg wieder.
Die ganze Beschreibung der Fehlerrückführung würde einen eigenen Text mit vielen mathematischen Details erfordern. Es gibt jedoch bereits viele gute kanonische Erklärungen, etwa das freie Online-Lehrbuch von Michael Nielsen, die Lektionen von Andrej Karpathy oder die Video-Reihe von 3Blue1Brown. Das Ziel dieses Artikels ist es nicht, das Berechnen eines Gradienten zu lehren, sondern zu zeigen, wie Rosenblatts Problem gelöst wurde.
Um die Idee zu verstehen, kann man sich den Lernprozess des Netzes wie einen Abstieg von einem Hügel im Nebel vorstellen. Die Höhe entspricht dem Fehler: je höher, desto stärker der Fehler des Netzes. Das Ziel ist, eine Niederung zu finden und dorthin abzusteigen, um diesen Fehler zu minimieren. Dafür muss man sich umsehen, verstehen, wo unten ist, und einen Schritt dorthin machen. Das ist das Gradientenverfahren. Aber der Hügel befindet sich dabei nicht in zwei Dimensionen, sondern in Tausenden, jeweils für jedes Gewicht des neuronalen Netzes, und wegen des Nebels ist es unmöglich, den ganzen Abstieg zu überblicken. Wie kann man verstehen, in welcher Richtung der Abstieg für jedes Gewicht liegt?
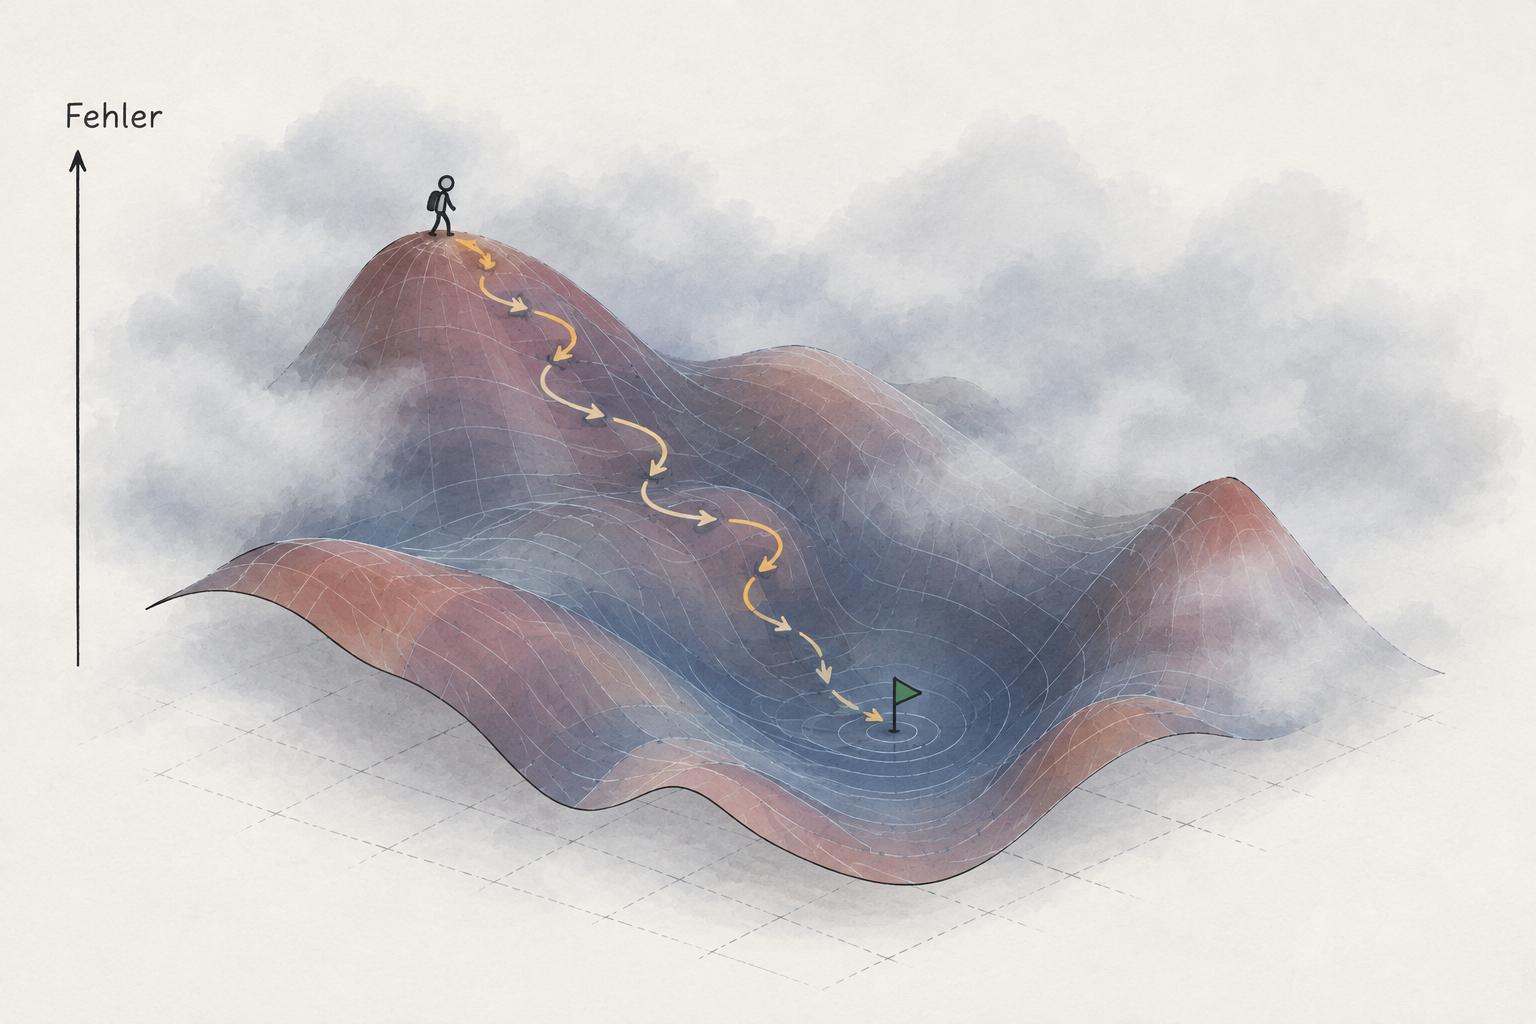
Auf diese Frage antwortet Backpropagation. Zuerst macht das Netz einen Durchgang (forward) und gibt ein Ergebnis aus. Danach wird es mit target verglichen, um den Fehler zu bekommen. Dieser Fehler wird rückwärts durch das Netz zurückgeleitet, von der Ausgabe zur Eingabe. Jedes versteckte Neuron erhält seinen eigenen Anteil an der "Mitschuld", der proportional zum Gewicht der Verbindung ist, über die sein Signal weitergeleitet wird: sein Beitrag zum Gesamtfehler. Dadurch bekommt ein verstecktes Neuron sein eigenes Fehlersignal, das aus den Fehlern der nächsten Schicht berechnet wurde. Damit erkennt man für jedes Gewicht Wert und Richtung der nötigen Änderung. Der Gradientenabstieg macht einen Schritt, dann wird alles wiederholt. Backprop findet eine Richtung und das Gradientenverfahren macht einen Schritt.
Tatsächlich ist es immer noch Rosenblatts Regel Δw = η · x · (target − y), aber mit einer Ausweitung auf versteckte Schichten. Allerdings müssen wir eine Änderung im Neuron machen. Eine Treppenfunktion passt nicht, da sie beim Erreichen einer Schwelle den Wert 1 liefert, andernfalls den Wert 0. Bei ihrer Verwendung gibt es keinen Gradienten, um zu verstehen, in welcher Richtung der Wert sich bewegen muss. Dafür muss die Aktivierungsfunktion stetig und differenzierbar sein. Deshalb wurde die Heaviside-Funktion durch die Sigmoidfunktion ersetzt:
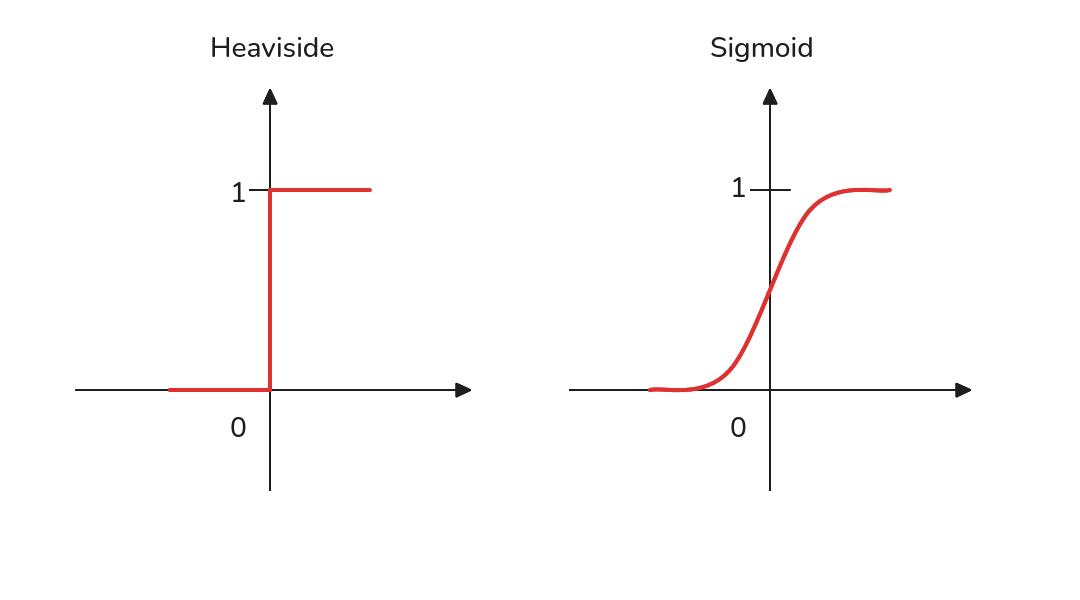
Die Ableitung der Sigmoidfunktion kann man durch die Funktion selbst ausdrücken:
Nun können wir das Fehlersignal (delta) für das Ausgabeneuron berechnen: delta = (target − y) · y · (1 − y). Das ist fast genau Rosenblatts Regel, die lediglich um einen Multiplikator erweitert wurde. Hinzu kommt ein weiterer Schritt: Ein verstecktes Neuron bekommt delta nicht aus target, sondern indirekt über das Gewicht seiner Verbindung vom Fehler des Ausgabeneurons.
Implementieren wir jetzt ein zweischichtiges Netz mit einer versteckten Schicht und trainieren es mithilfe der Backpropagation auf den Ringdaten, bei denen das Perzeptron unbrauchbar war:
import math
import random


class Neuron:
    def __init__(self, n_inputs, learning_rate):
        # Zufällige Startwerte statt Nullen: sonst lernen alle
        # versteckten Neuronen exakt dasselbe
        self.weights = [random.uniform(-1, 1) for _ in range(n_inputs)]
        self.bias = random.uniform(-1, 1)
        self.learning_rate = learning_rate

    def sigmoid(self, x):
        # Glatte Aktivierungsfunktion statt der Treppenfunktion.
        # Sie ist differenzierbar - genau das braucht Backpropagation.
        return 1 / (1 + math.exp(-x))

    def sigmoid_derivative(self, fx):
        # Ableitung, ausgedrückt durch den Ausgabewert fx = sigmoid(x)
        return fx * (1 - fx)

    def feedforward(self, inputs):
        # Wie Perceptron.predict: gewichtete Summe + Bias,
        # dann die Aktivierungsfunktion. Eingaben und Ausgabe
        # merken wir uns für den Rückwärtsdurchlauf
        self.inputs = inputs
        s = sum(x * w for x, w in zip(inputs, self.weights)) + self.bias
        self.output = self.sigmoid(s)
        return self.output

    def update(self, delta):
        # Wie die Perzeptron-Lernregel Δw = η · x · (target − y),
        # nur steht statt (target - y) das Fehlersignal delta
        for i in range(len(self.weights)):
            self.weights[i] += self.learning_rate * self.inputs[i] * delta
        self.bias += self.learning_rate * delta


class Network:
    def __init__(self, n_inputs, n_hidden, learning_rate=0.1):
        # Versteckte Schicht: mehrere Neuronen mit denselben Eingaben
        self.hidden = [Neuron(n_inputs, learning_rate) for _ in range(n_hidden)]
        # Ausgabeneuron: bekommt die Ausgaben der versteckten Schicht
        self.output = Neuron(n_hidden, learning_rate)

    def feedforward(self, inputs):
        hidden_outputs = [n.feedforward(inputs) for n in self.hidden]
        return self.output.feedforward(hidden_outputs)

    def backward(self, target):
        # Fehlersignal des Ausgabeneurons: wie beim Perzeptron (target - y),
        # multipliziert mit der Ableitung
        o = self.output.output
        delta_output = (target - o) * self.output.sigmoid_derivative(o)

        # Fehlersignale der versteckten Neuronen: jedes bekommt
        # seinen Anteil am Fehler über das Gewicht seiner Verbindung
        # zum Ausgabeneuron - ein eigenes target braucht es nicht
        deltas_hidden = [
            delta_output * self.output.weights[j] * n.sigmoid_derivative(n.output)
            for j, n in enumerate(self.hidden)
        ]

        # Erst jetzt die Gewichte anpassen
        self.output.update(delta_output)
        for n, delta in zip(self.hidden, deltas_hidden):
            n.update(delta)

    def train(self, training_data, epochs):
        for epoch in range(epochs):
            errors = 0
            for inputs, target in training_data:
                prediction = self.feedforward(inputs)
                if (1 if prediction >= 0.5 else 0) != target:
                    errors += 1
                self.backward(target)

            # Der Kürze halber geben wir nur jede fünfte Epoche aus
            if (epoch + 1) % 5 == 0 or epoch == 0:
                print(
                    f"Epoche {epoch + 1:>3}: {errors} Fehler von {len(training_data)}"
                )


random.seed(42)  # für reproduzierbare Ergebnisse


# Erzeugt Objekte in einem ringförmigen Bereich um das Zentrum.
# r0..r1 ist der Abstand vom Zentrum, der Winkel ist zufällig.
def generate_objects(n, r0, r1, label):
    objects = []
    for _ in range(n):
        r = random.uniform(r0, r1)
        theta = random.uniform(0, 2 * math.pi)
        x = r * math.cos(theta)
        y = r * math.sin(theta)
        objects.append(([x, y], label))
    return objects


# Inneres, kompaktes System (z.B. innere Planeten) -> Klasse 0
# Äußerer Gürtel (z.B. Kuipergürtel-Objekte) -> Klasse 1
inner = generate_objects(50, 0.0, 2.5, 0)
outer = generate_objects(50, 4.0, 6.0, 1)
training_data = inner + outer
random.shuffle(training_data)

net = Network(n_inputs=2, n_hidden=8)  # Eingabe: Position X und Position Y
net.train(training_data, epochs=50)
Das Ergebnis ist:
Epoche   1: 55 Fehler von 100
Epoche   5: 44 Fehler von 100
Epoche  10: 25 Fehler von 100
Epoche  15: 11 Fehler von 100
Epoche  20: 9 Fehler von 100
Epoche  25: 1 Fehler von 100
Epoche  30: 0 Fehler von 100
Epoche  35: 0 Fehler von 100
Epoche  40: 0 Fehler von 100
Epoche  45: 0 Fehler von 100
Epoche  50: 0 Fehler von 100
In der ersten Epoche bekommen wir die gleiche Anzahl an Fehlern wie beim Perzeptron (~55). Zehn Epochen sind nicht genug, um unser Netz zu trainieren, deswegen machen wir 50. In Fünferschritten sank die Anzahl der Fehler in unserem Fall: 44 -> 25 -> 11 -> 9 -> 1 -> 0. Die versteckte Schicht fand eine geschlossene Kurve um den zentralen Kern, die das Perzeptron nicht finden konnte.
Geben wir Daten des Sonnensystems im unser trainiertes Netz ein, um uns zu überzeugen, dass es funktioniert. Die Radien sind realistische große Halbachsen der Umlaufbahnen, die durch 10 geteilt wurden:
# Große Halbachse in AE (Wikipedia) und frei gewählter Winkel in Grad
sun_system = {
    "Sonne": (0.0, 0),
    "Merkur": (0.387, 59),
    "Erde": (1.0, 13),
    "Jupiter": (5.203, 47),
    "Saturn": (9.537, 345),
    "Uranus": (19.191, 60),
    "Neptun": (30.069, 358),
    "Pluto": (39.482, 300),
    "Makemake": (45.792, 190),
    "Eris": (67.668, 25),
}

for name, (distance, angle) in sun_system.items():
    r = distance / 10
    x = r * math.cos(math.radians(angle))
    y = r * math.sin(math.radians(angle))

    prediction = net.feedforward([x, y])
    klasse = "Kuipergürtel" if prediction >= 0.5 else "inneres System"
    print(f"{name}: {klasse} ({prediction:.2f})")
Das Perzeptron gab nur 0 oder 1 aus. Die Sigmoidfunktion gibt eine Zahl zwischen 0 und 1 aus, z.B. 0,8 bei Sonne und Erde und 0,82 bei Eris. Die Ausgabe der Sigmoidfunktion ist ein Maß für die Sicherheit:
Sonne: inneres System (0.08)
Merkur: inneres System (0.08)
Erde: inneres System (0.08)
Jupiter: inneres System (0.09)
Saturn: inneres System (0.11)
Uranus: inneres System (0.30)
Neptun: Kuipergürtel (0.57)
Pluto: Kuipergürtel (0.67)
Makemake: Kuipergürtel (0.74)
Eris: Kuipergürtel (0.82)
Interessant an der Ausgabe ist Neptun. Das Netz antwortete, dass es zum Kuipergürtel gehört, aber die Sicherheit ist nur 0,57. Das Netz hat geraten. Das passiert, weil es in der Trainingsstichprobe keine Objekte bei r = 3.0 gab. Das Netz weiß nur, was in den Daten war.
Die Backpropagation ermöglichte es, nicht nur Geraden zu legen, sondern Grenzen mit beliebigen Formen zu ziehen. Damit war der Grundstein für tiefe Netze und Deep Learning gelegt.